Изображения в LLM API: OCR, скриншоты и документы
Vision LLM API подходит для задач, где изображение нужно прочитать, объяснить или сверить с правилами. Для OCR счёта, таблицы на скриншоте, графика или страницы документа важен не красивый ответ, а результат, который приложение сумеет проверить до следующего шага.
Коротко
Сначала оставьте в кадре только то, что относится к вопросу.
Просите структуру ответа и отдельный признак неопределённости.
Значимые поля проверяйте правилами приложения, а не доверием к свободному тексту модели.
Какие задачи решают изображения в LLM API
Один и тот же запрос с картинкой может отвечать на очень разные вопросы. В OCR обычно нужны поля: номер документа, дата, сумма, строки таблицы. В интерфейсных задачах полезнее список различий между двумя состояниями. Для графика запрос должен перечислять серии, подписи и диапазоны, которые требуется извлечь.
Я бы не собирал универсальный промпт «прочитай картинку». Он быстро расползается на случайные ответы. Лучше назвать тип входа, ожидаемые поля, допустимый формат и действие при сомнении. Например, модель может вернуть значение как нечитаемое вместо догадки. Для финансового документа это честнее и полезнее.
Сначала выберите модель с поддержкой визуального ввода в каталоге. Перед интеграцией проверьте capability vision, статус и цену. Не берите ID из старого руководства.
Как подготовить изображение перед запросом
Оригинал с телефона редко оказывается хорошим входом. На нём бывают поля вокруг документа, уведомления, адресная строка браузера, личные данные и мелкий текст, который не относится к задаче. Обрезка решает сразу две проблемы: модель получает меньше шума, а команда легче объясняет, какие данные ушли в обработку.
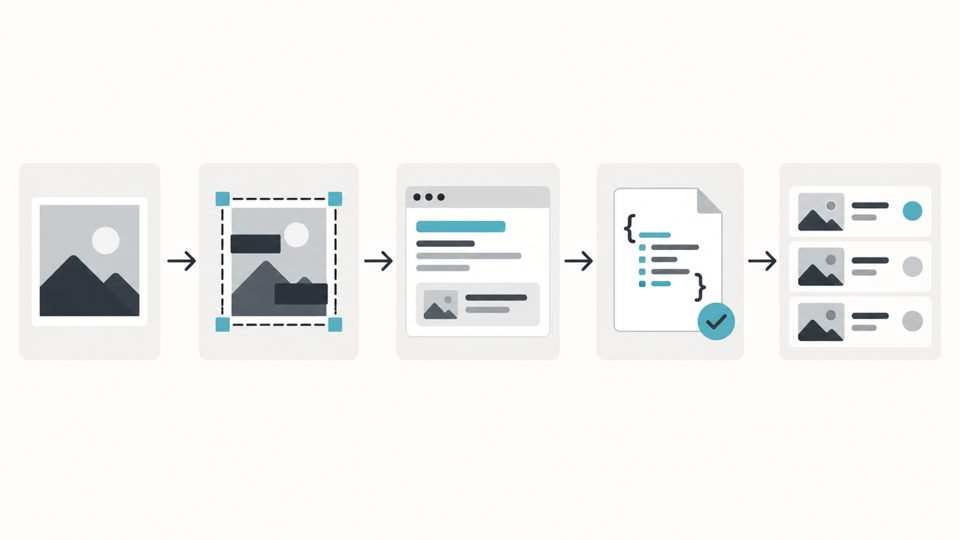
Практичный порядок выглядит так:
Найдите участок, содержащий вопрос. Для счёта это может быть таблица строк, для интерфейса - область с ошибкой.
Закройте секреты и лишние персональные сведения до отправки. Если их нельзя убрать без потери смысла, задачу лучше остановить и согласовать другой путь.
Проверьте читаемость мелкого текста глазами. Растянутый или размытый фрагмент модель не превратит в достоверный источник.
Приложите короткое описание: что показано, какой язык, какие поля нужны и какие значения недопустимы.
Провалидируйте ответ. Дата должна пройти парсер даты, сумма - проверку формата, а идентификатор - правила вашей системы.
У Relay есть документация для Messages API и для Chat Completions. Протокол выбирают по клиенту и коду приложения. Логику подготовки файла разумнее держать до вызова API, там же, где действует ваша политика обработки данных.
Как формулировать OCR-задачу
Требование «верни JSON» полезно, когда за ним стоит реальная схема. Набор полей лучше сделать коротким, а неизвестное значение разрешить вернуть пустым. Тогда валидатор отличит отсутствие уверенности от сломанного формата.
Для чека схема может содержать дату, валюту, итог и список строк. Для скриншота ошибки подходят заголовок, видимый код, текст сообщения и список элементов управления. Вопрос о графике стоит разделить: сначала модель называет подписи осей и легенду, потом извлекает значения, если они действительно читаются.
Не просите модель подтверждать факт, которого на изображении нет. Она может хорошо описывать видимое, но не знает, почему оператор изменил показатель на дашборде или кто подписал документ. Такие выводы появляются только после сверки с вашей базой.
Где OCR требует дополнительной проверки
Первая группа риска - данные, которые запускают действие: перевод денег, смена реквизитов, блокировка клиента, юридическое решение. Вторая - похожие символы, мелкие дроби и многострочные таблицы. Третья - изображения, где контекст обрезан так, что цифра существует без названия поля.
В этих случаях модель должна помогать оператору, а не подменять его. Хороший интерфейс показывает исходный фрагмент, результат распознавания и причину, по которой запись попала в ручную очередь. Такой подход медленнее на первом экране, зато ошибка не исчезает в автоматизации.
Если документ содержит персональные данные, начните с политики конфиденциальности и описания обработки данных. Relay не заменяет внутренние правила компании по доступу к документам. Он даёт API-вызов, а границы допустимых данных задаёт владелец процесса.
Что делать со скриншотами и графиками
Скриншот полезен, когда вопрос привязан к состоянию интерфейса: «какая ошибка видна», «что изменилось после релиза», «какие поля заполнены». Перед сравнением двух экранов дайте им роли: прежнее и новое состояние, эталон и кандидат, пользовательский экран и административный. Без этой подписи ответ часто становится расплывчатым.
График сложнее текста. У него есть масштаб, линии, легенда и иногда подписи, которые закрывают точки. Поэтому я бы использовал два шага: сначала попросил модель перечислить, что она способна прочитать, затем проверил числа на исходных данных или визуально. Полученный текст годится для чернового разбора, но не для отчёта без проверки.
Внешний вид не доказывает факт. Это правило особенно спасает при QA: скриншот может показать симптом, однако причину нужно искать в журнале приложения и в воспроизводимом сценарии.
Как контролировать расход и результат
Визуальный запрос стоит учитывать отдельно от текстовых задач. Сохраняйте у себя тип сценария, версию промпта, идентификатор модели, признак ручной проверки и итоговое решение. Содержимое документов в технический журнал класть не нужно, если без него можно разобраться в сбое.
В Relay для анализа вызовов есть журнал запросов, а параметры использования доступны в кабинете. Он помогает связать попытку с request ID, моделью, токенами, статусом и стоимостью. Сам текст запроса и ответа Relay не сохраняет, поэтому для разбора собственной бизнес-логики приложению нужны свои безопасные метаданные.
Проверьте и обработку ошибок. Если ответ не прошёл вашу схему, не отправляйте его дальше как будто он верный. Сохраните безопасную причину отказа, предложите загрузить более читаемый фрагмент или направьте случай оператору. Маршруты и форматы ошибок описаны в справочнике ошибок.
Как собрать набор для проверки качества
До запуска соберите образцы, похожие на будущий поток. В набор нужны чистые сканы, слабые фотографии, документы с несколькими таблицами, заполненные формы, повёрнутые страницы и кадры, где нужного поля нет. Для каждого образца заранее выпишите ожидаемую структуру, допустимые варианты и действие при неопределённости.
Считайте долю распознанных полей и ошибки по типам: число прочитано неверно, поле перепутано с соседним, модель достроила отсутствующее значение, результат ушёл в ручную очередь. Такая разбивка показывает, что исправлять: подготовку файла, промпт, схему валидации или процесс оператора.
Набор не должен содержать реальные секреты и документы клиентов без согласованного основания. Для теста можно использовать синтетические образцы с той же структурой и типовые обезличенные фрагменты. Смена модели или шаблона запроса требует повторного прогона на том же наборе, иначе сравнение будет случайным.
Как использовать обратную связь оператора
Ручная очередь не должна быть чёрным ящиком. Оператор может отметить, что поле прочитано верно, что нужно было другое кадрирование или что задача вообще не подходит для автоматического разбора. Эти причины попадают в набор проверки и постепенно делают правила точнее.
Не исправляйте результат модели в тишине. Сохраните связь между исправлением и типом ошибки без копии чувствительного документа. Тогда видно, какие шаблоны нужно изменить, а какие исключения лучше оставить человеку. У хорошего процесса модель берёт рутинное, а оператор разбирает случаи, где цена неправильного поля высока.
Vision не подходит для задачи, где нужна точная координата, юридически значимая расшифровка без контроля или решение по одному неразборчивому снимку. В таких случаях изображение остаётся доказательством для человека, а модель может лишь помочь с предварительной сортировкой.
Вопросы и ответы
Можно ли использовать LLM вместо обычного OCR?
Можно, когда помимо чтения символов нужно понять структуру документа, сопоставить подписи и вернуть поля в схеме. Для массового потока всё равно нужен набор проверок: формат дат, обязательные поля, контроль сумм и очередь исключений. Модель не отменяет такую проверку, а добавляет слой интерпретации.
Как понять, что изображение подготовлено достаточно хорошо?
Попросите человека, который не видел исходный документ, прочитать нужное поле с подготовленного фрагмента. Если он сомневается, модели тоже будет трудно. Затем включите этот тип изображения в свой тестовый набор и сравнивайте долю валидных результатов после каждой смены модели или промпта.
Нужно ли сохранять исходные изображения для отладки?
Это решение зависит от вашей политики и цели обработки. Часто хватает хеша файла, типа сценария, версии промпта, результата проверки и ссылки на защищённое внутреннее хранилище с ограниченным сроком. Не превращайте технический журнал в вторую копию чувствительных документов.