Ошибки Claude API: 529, 500, 429, 400 и 401, что делать
Ошибка 529 overloaded значит, что API Anthropic временно перегружен, а ваш запрос тут ни при чём. Через Relay вы 529 не увидите: перегрузка приходит как 429 pool_exhausted, 502 upstream_error или 503 service_unavailable, и все три можно повторять с паузой. Ошибки 400 и 401 повтором не исправить: причина в запросе или в ключе, и чинить нужно её.
Коротко
В справочнике ошибок Relay кода 529 нет. Перегрузка модели приходит как 429
pool_exhausted, 502upstream_errorили 503service_unavailable, у всех трёхx-should-retry: true.Повторяйте по
x-should-retryиRetry-After, с потолком на число попыток и случайной добавкой к паузе. Ошибки 400, 401, 402, 403 и 404 повтор не исправит.Ссылка на
/docs/errorsв тексте ошибки говорит, что ответил шлюз. Текст без ссылки чаще всего пришёл от самой модели (400, 403, 413, 422), и чинить нужно запрос.
Что значит 529 и почему его нет в ответах Relay?
Anthropic описывает 529 как overloaded_error: API временно перегружен. На странице ошибок вендора сказано, что такое случается при высоком трафике у всех пользователей сразу (по странице на 14 октября 2026 года). От вашего ключа, квоты и промпта это не зависит, и менять запрос бессмысленно.
Relay отвечает собственными кодами. Для клиентов формата Anthropic Messages у обоих кодов 503 тип overloaded_error, у 500, 502 и 504 тип api_error, у всех 429 тип rate_limit_error. Поэтому в обработчике ловите класс ошибки по x-should-retry, а не жёсткую пару «529 и повторить». Такая пара в связке с Relay молча не сработает.
Ошибка может прийти и после ответа 200. Когда поток уже пошёл, статус не изменить, и сбой выглядит как событие error в потоке или как обрыв соединения. Anthropic прямо пишет, что при перегрузке overloaded_error может прийти событием внутри потока. Формат потока разобран в руководстве по streaming.
Какие ошибки повторять, а какие чинить?
| Статус и код | Что случилось | Повтор | Что делать |
|---|---|---|---|
400 invalid_request | запрос не принят: поле, JSON, роль; тот же код у 405 и 422 | нет | прочитать param и текст, исправить запрос |
401 invalid_api_key | ключ не передан, отключён, удалён или набран с ошибкой | нет | проверить значение ключа и заголовок |
402 insufficient_balance, key_limit_exceeded | кончились деньги на балансе или в лимите ключа | нет | пополнить баланс или поднять лимит ключа |
403 model_not_allowed, user_blocked, request_forbidden | модель запрещена ключу, аккаунт заблокирован или модель отказалась обработать запрос | нет | настройки ключа, поддержка, содержимое запроса |
404 model_not_found | такой модели нет | нет | взять идентификатор из каталога |
408 request_timeout | тело не дошло за отведённое время или модель не успела | да | повторить |
413 request_too_large | запрос больше допустимого | нет | сократить запрос |
429 rate_limited, concurrency_limit, pool_exhausted | темп, число потоков или занятая мощность модели | да | выдержать Retry-After |
500 internal_error | внутренняя ошибка шлюза | да | повторить, при повторении написать в поддержку с request_id |
502 upstream_error | модель ответила ошибкой или не ответила | да | выдержать Retry-After |
503 service_unavailable | сервис перегружен или перезапускается | да | выдержать Retry-After |
503 model_unavailable | модель сейчас недоступна, в том числе пока для неё нет цены | нет | выбрать другую модель или вернуться позже |
504 upstream_timeout | модель не прислала ни байта вовремя | со stream: true да, без потока нет | включить поток |
Два 503 из таблицы ведут себя по-разному, и это главная причина смотреть на x-should-retry, а не на статус. У model_unavailable заголовок Retry-After есть, но x-should-retry равен false: автоматически такой запрос повторять не нужно. Про 429 отдельно рассказывает статья про ошибку 429 и Retry-After, а виды лимитов разобраны в материале про rate limits. Полный перечень кодов лежит в справочнике ошибок.
Из-за чего бывают 400, 401 и 413?
Эти три ошибки повтор не лечит, и причины у них приземлённые.
400 в Relay приходит, когда тело запроса не разобрать: не JSON, нет поля model, stream не логическое значение, max_tokens вне диапазона от 1 до 16777216. Остальные проверки делает сама модель: порядок ролей, обязательные поля, формат инструментов. В таком случае текст ошибки пришёл от неё, и он обычно называет сломанное поле. Шлюз принимает запрос формата Messages и без max_tokens, но модель может его потребовать, так что при 400 с намёком на это поле добавьте его.
401 получают, когда ключ набран с ошибкой (неверная длина или контрольная сумма), неизвестен, отключён, удалён или просрочен. Сообщение у всех этих случаев одно, Invalid API key: по тексту опечатку от отозванного ключа не отличить. Если ключ не передан вовсе, сообщение другое, оно подсказывает заголовки Authorization: Bearer и x-api-key. Порядок проверки собран в статье про ошибки авторизации по ключу.
413 значит, что запрос больше допустимого для шлюза или модели. Сократите историю диалога, вложения и тела инструментов. Повтор того же запроса даст тот же ответ.
Как повторять, чтобы не усугубить перегрузку?
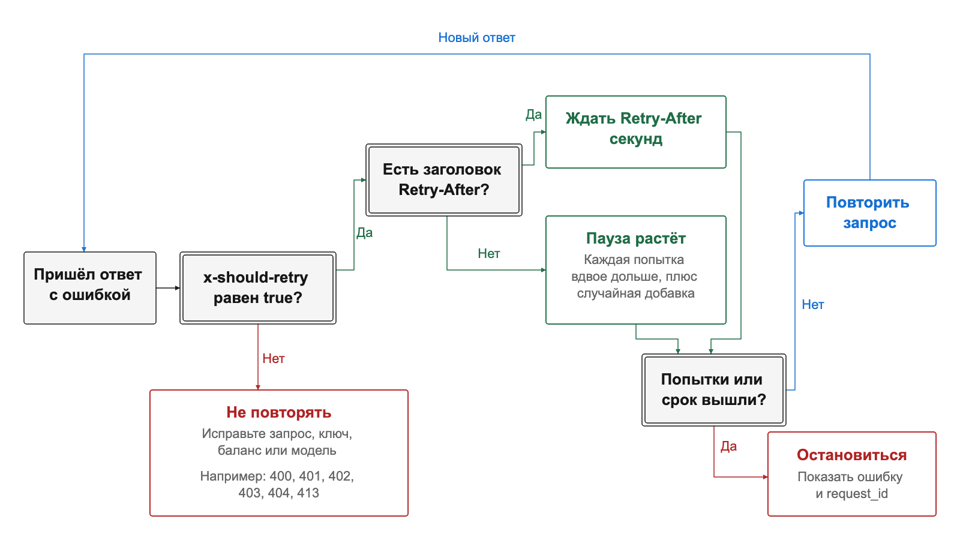
Алгоритм короткий:
Прочитайте
x-should-retry. Если там неtrue, остановитесь и исправьте причину.Возьмите паузу из
Retry-After. Если заголовка нет, как у 500 и 504, расширяйте паузу с каждой попыткой.Добавьте случайную часть, чтобы параллельные воркеры не вернулись одновременно.
Ограничьте число попыток и общий срок задачи.
Когда лимиты исчерпаны, покажите пользователю явную ошибку с
request_id.
Тот же алгоритм в коде. Повторяются ответы с x-should-retry: true, ошибки соединения, при которых запрос до шлюза не дошёл, и 503 без этого заголовка, но с Retry-After: такой ответ даёт прокси перед шлюзом, когда сам шлюз недоступен. Параметр budget задаёт общий срок задачи: каждая попытка и каждая пауза тратят остаток, а asyncio.timeout обрывает запрос, который в остаток не уложился. Для asyncio.timeout нужен Python 3.11 или новее.
import asyncio
import os
import random
import time

import httpx

URL = "https://relay-llm.ru/v1/chat/completions"
HEADERS = {"Authorization": f"Bearer {os.environ['RELAY_API_KEY']}"}


class RelayError(Exception):
    def __init__(self, response):
        try:
            payload = response.json()
        except ValueError:
            payload = None
        error = payload.get("error") if isinstance(payload, dict) else None
        error = error if isinstance(error, dict) else {}
        self.status = response.status_code
        self.code = error.get("code")
        self.request_id = response.headers.get("x-request-id")
        super().__init__(f"{self.status} {self.code} request_id={self.request_id}")


def should_retry(response):
    flag = response.headers.get("x-should-retry")
    if flag is not None:
        return flag == "true"
    return response.status_code == 503 and "retry-after" in response.headers


def backoff(attempt):
    return random.uniform(0, min(30, 2**attempt))


def pause_after(response, attempt):
    retry_after = response.headers.get("retry-after", "")
    if retry_after.isdigit():
        return int(retry_after) + random.uniform(0, 1)
    return backoff(attempt)


async def ask(client, prompt, attempts=4, budget=90.0):
    deadline = time.monotonic() + budget
    body = {"model": "claude-sonnet-5", "messages": [{"role": "user", "content": prompt}]}
    error = None
    for attempt in range(attempts):
        remaining = deadline - time.monotonic()
        if remaining <= 0:
            break
        try:
            async with asyncio.timeout(remaining):
                response = await client.post(URL, headers=HEADERS, json=body)
        except httpx.ConnectError as exc:
            error, pause = exc, backoff(attempt)
        else:
            if response.is_success:
                return response.json()
            error = RelayError(response)
            if not should_retry(response):
                raise error
            pause = pause_after(response, attempt)
        if attempt == attempts - 1 or deadline - time.monotonic() < pause:
            break
        await asyncio.sleep(pause)
    raise error


async def main():
    async with httpx.AsyncClient(timeout=httpx.Timeout(10.0, read=120.0)) as client:
        answer = await ask(client, "Привет")
        print(answer["choices"][0]["message"]["content"])


if __name__ == "__main__":
    asyncio.run(main())
Таймаут чтения и обрыв по сроку здесь намеренно не повторяются. Повтор после своего таймаута может отправить запрос, который модель уже обрабатывает. По правилам Relay повтор считается самостоятельным запросом, и его стоимость зависит от его собственного исхода. Если шлюз ответил ошибкой до первого байта ответа модели, запрос не списывается. Если шлюз уже отправил запрос модели и не дождался первого байта (upstream_timeout) или вы закрыли соединение после отправки, но до первого байта, у текстовых запросов списывается оценка входа. Пока запрос модели не отправлен, резерв освобождается и списания нет. Отсюда практическое правило: свой таймаут не делайте короче, чем нужно длинному запросу для первого токена.
Если вы ходите в Relay через официальный SDK Anthropic, учтите, что он сам повторяет временные ошибки, по умолчанию дважды, и учитывает retry-after (по странице ошибок Anthropic на 14 октября 2026 года). Своя обёртка на четыре попытки поверх этого даст до двенадцати запросов вместо четырёх. Параметр max_retries позволяет отключить повторы SDK или оставить их единственными.
Четыре попытки и общий срок задачи я бы брал как стартовую точку, а не как закон. Больше попыток ничего не лечит: если за минуту мощность не вернулась, пользователю полезнее честное сообщение, чем ещё один круг ожидания.
Как быть с таймаутами 408 и 504?
408 значит, что тело запроса не дошло за отведённое время или модель не успела обработать запрос. Его можно повторять. 504 upstream_timeout строже: модель не прислала ни байта вовремя. В запросе со stream: true x-should-retry у него равен true, без потока false. Поэтому длинные ответы запрашивайте потоком, даже если пользователю текст целиком показывается в конце. Тот же совет даёт Anthropic на странице ошибок: для долгих запросов лучше использовать streaming. Как читать такой поток, описано в том же руководстве.
Как проверить обработчик ошибок?
Ветку «не повторять» полезно прогнать заведомо неверным запросом и убедиться, что клиент останавливается с первой попытки. По справочнику ошибок неизвестная модель даёт 404 model_not_found, а неверный ключ 401 invalid_api_key, у обоих x-should-retry: false. Для такой проверки возьмите отдельный тестовый конфиг и не копируйте отсутствующий ID в рабочую команду.
Для 401 подставьте в заголовок заведомо неверное значение. Не гоняйте такие проверки сотнями: адрес, с которого много раз присылали неверные ключи, тоже получает rate_limited.
Как отличить ошибку Relay от ошибки модели?
Смотрите на текст сообщения. К ответам шлюза Relay дописывает ссылку вида /docs/errors#код, и по ней видно, какая строка справочника описывает ошибку. В формате Anthropic отдельного поля code нет, поэтому код виден только в этой ссылке. У ошибок, текст которых пришёл от модели (это бывает у 400, 403, 413 и 422), ссылки нет. Такой текст обычно называет сломанное поле, и лечится он правкой запроса. Правило не охватывает ответ прокси при недоступном шлюзе: у него тоже нет ссылки, но это временный 503.
Идентификатор запроса приходит с ответами шлюза. request_id в теле ошибки совпадает с заголовком x-request-id, его и нужно сохранять в логах и передавать поддержке. У 503 от прокси идентификатора нет, тогда фиксируйте время и адрес запроса. Что именно писать в логи, рассказано в статье про request_id и логи.
Для запросов, дошедших до модели, в журнале запросов кабинета видны статус, маршрут (основной или резервный) и число повторов. Заголовок ответа x-route показывает то же: primary или fallback. Шлюз переходит на резервный маршрут только до того, как модель начала отвечать, и такой запрос оплачивается по цене сработавшего маршрута. Ограничить резерв можно в настройках ключа или заголовком x-fallback-policy: any, not_pricier или off. С off при недоступном основном маршруте запрос получит ошибку, поэтому для задач, где важнее доставить ответ, это значение не подходит. Подробности в разделе про резервные маршруты.
Что менять в Claude Code при перегрузке?
Claude Code повторяет временные сбои до десяти раз с нарастающей паузой, прежде чем показать ошибку (документация Claude Code на 14 октября 2026 года). Поэтому ошибка на экране означает, что повторы уже были. Вручную повторяйте не сразу, а через несколько минут: так советует и сама документация.
Что помогает по документации Claude Code:
переключить модель командой
/model: вместимость считается отдельно по каждой модели;для фоновых запусков и CI включить
CLAUDE_CODE_RETRY_WATCHDOG=1, тогда Claude Code повторяет ошибки мощности без ограничения числа попыток;в скриптах, которым нужно упасть быстро, снизить
CLAUDE_CODE_MAX_RETRIES.
Для Relay добавьте одно: если приходит model_unavailable, повторы бесполезны по определению, потому что x-should-retry равен false. Берите другую модель из каталога на странице моделей. Если перегрузка совпала с резервными маршрутами, проверьте в настройках ключа значение fallback_policy.
Придёт ли ошибка 529 в ответе Relay?
Нет. В справочнике ошибок Relay такого кода нет, а перегрузка модели приходит как 429 pool_exhausted, 502 upstream_error или 503 service_unavailable. Ориентируйтесь на x-should-retry и Retry-After, а не на номер статуса.
Виноват ли я в ошибке 502 upstream_error?
Как правило, нет: это ответ о том, что модель вернула ошибку или не ответила. Повторите запрос после паузы из Retry-After. Если ошибка не уходит несколько попыток подряд, напишите в поддержку и приложите request_id, время и код ошибки. Полный ключ присылать не нужно.
Сколько раз повторять запрос?
Я бы взял три или четыре попытки и общий срок задачи. Это выбор автора, а не правило Relay. Чем больше попыток, тем дольше пользователь ждёт и тем сильнее вы нагружаете модель в момент перегрузки.
Сколько стоит повтор запроса?
Повтор считается новым запросом, а его стоимость зависит от его исхода. Ошибка шлюза до первого байта ответа модели не списывается. Если шлюз уже отправил запрос модели, а вы закрыли соединение до первого байта или шлюз не дождался его сам, у текстовых запросов списывается оценка входа.
Источники
Claude API errors, документация Anthropic, проверено 14 октября 2026 года.
Streaming messages, документация Anthropic, проверено 14 октября 2026 года.
Error reference, документация Claude Code, проверено 14 октября 2026 года.