Как снизить стоимость LLM API: семь приёмов по порядку
Счёт за LLM API сокращают в определённом порядке: сначала смотрят, из чего он состоит, потом ставят потолок на ключ и лишь после этого лезут в сами запросы. Ниже семь приёмов в таком порядке. У каждого сказано, когда он не сработает, иначе список превращается в набор советов на удачу.
Коротко
Начните с журнала запросов и потолка на ключе. Токены они не экономят, зато показывают, куда те уходят, и ограничивают худший месяц.
Дальше по очереди: короткий выход, модель под задачу, кэш повторяемого префикса, меньший контекст, меньше платных повторов.
Пакетного режима в Relay нет, скидки за «подождать до суток» не будет.
Эффекты приёмов не складываются в простую сумму, поэтому после каждого шага сверяйтесь с журналом.
Из чего складывается цена запроса
Запрос оплачивается по частям: вход без кэша, запись в кэш, чтение из кэша и выход. У каждой части своя ставка за миллион токенов, и в деталях запроса в журнале они расписаны построчно.
C = n_вход × p_вход + n_запись × p_запись + n_чтение × p_чтение + n_выход × p_выходЗдесь n задаёт число токенов части в миллионах, а p её ставку за миллион из карточки модели. Приёмы ниже отличаются тем, на какую часть формулы они давят. Как собрать эти числа и применить формулу к чату, агенту и классификации, показано в статье про оценку стоимости запросов.
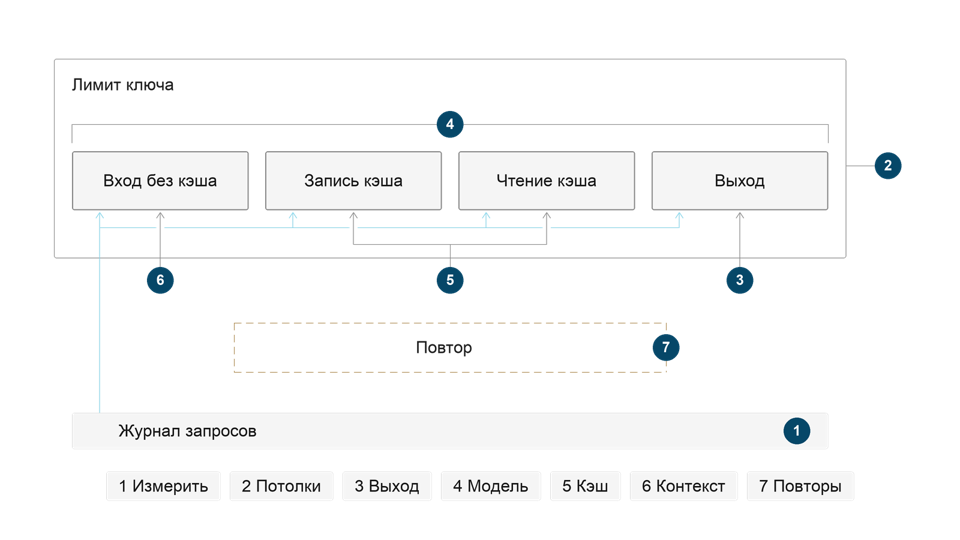
Длины блоков на схеме одинаковы нарочно: доли расхода у каждой нагрузки свои, и узнать их можно только из собственного журнала.
| Приём | Трудоёмкость | На что действует | Не сработает, если |
|---|---|---|---|
| 1. Измерить | минуты | на все части: даёт данные | трафик идёт под одним общим ключом |
| 2. Потолки | минуты | на худший месяц, не на цену | лимит выставлен «с запасом в десять раз» |
| 3. Выход | правка запроса | на выход | нужен длинный связный текст |
| 4. Модель | правка кода и проверка качества | на все ставки сразу | ошибка стоит дороже экономии |
| 5. Кэш | правка порядка блоков | на вход, который повторяется | запросы реже, чем живёт запись |
| 6. Контекст | правка кода | на вход | следующему шагу нужна конкретная строка истории |
| 7. Повторы | конфигурация и клиент | на оплаченные впустую вызовы | доступность важнее цены |
С чего начать: журнал и потолок на ключе
Пока нет разбивки, любая оптимизация идёт вслепую. Откройте журнал, выберите период и выгрузите CSV: в файле есть ключ, модель, токены по частям цены и сумма каждого запроса. Чтобы увидеть, кто тратит, сгруппируйте сумму по ключу и модели.
import csv
from collections import defaultdict

totals = defaultdict(float)
with open("requests.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        totals[(row["key_prefix"], row["model"])] += float(row["charge_usd"])

for (key, model), usd in sorted(totals.items(), key=lambda item: -item[1]):
    print(f"{key:<16}{model:<28}{usd:10.4f}")
Записи о запросах хранятся 90 дней (сроки перечислены на странице безопасности), так что выгружайте журнал раз в месяц, пока старые строки не исчезли.
Второй шаг занимает ещё меньше времени. У ключа три лимита расхода в долларах (на всё время, на день и на месяц), отдельный предел запросов в минуту и список разрешённых моделей. Запрос сверх лимита получает ошибку key_limit_exceeded с кодом 402, и деньги не списываются. Лимит не делает токен дешевле, он ограничивает худший месяц. Заведите ключ на каждое приложение и окружение. Если весь трафик идёт под одним ключом, журнал показывает одну строку, а лимит останавливает всех сразу.
Как сократить выход и не сломать ответ?
Ставки выхода у текстовых моделей каталога обычно выше ставок входа, и у каждой модели отношение своё. Простой пример на условных числах: при ставках 2 и 10 условных единиц за миллион запрос с 3000 токенов входа и 600 токенов выхода стоит 0,006 за вход и 0,006 за выход. Выхода в пять раз меньше, а платят за него поровну.
Что можно сделать:
Просите только то, что разберёт читатель ответа. Если ответ читает программа, пояснения до и после JSON или кода тоже оплачиваются как выход.
Задайте
max_tokensпо реальной длине ответа с запасом. Это потолок, а не цена: платят за сгенерированное. Но шлюз резервирует деньги под верхнюю оценку запроса, а безmax_tokensоценка берётся по максимальной длине ответа модели из каталога. Лишний запас занимает баланс и остаток лимита ключа.Если модель поддерживает стоп-последовательности (
stopв Chat Completions,stop_sequencesв Messages), используйте их там, где формат ответа известен заранее.
Оборвать поток раньше времени тоже можно, но не рассчитывайте на точную экономию: Relay тарифицирует закрытый поток по расходу, который успел получить, и оценивает остальное. В журнале такой запрос помечен «Прерван клиентом; расход оценён». Приём не годится для ответов, которые нужны целиком: усечённый JSON не разбирается.
Как выбрать модель под задачу без угадывания?
Одна модель на все шаги: самый дорогой вариант по умолчанию. Разделите шаги на два типа: где ответ проверяется простым правилом (метка из списка, поля из текста, да или нет) и где нужно рассуждение. Для первых берите самую дешёвую модель, которая проходит вашу проверку, для вторых оставляйте сильную. Карточки ниже показывают, как выглядит разница ставок, цены в них приходят из каталога.
Критерий выбора здесь не бренд, а доля верных ответов на ваших примерах. Соберите пятьдесят-сто примеров задачи с эталонными ответами, прогоните обе модели и сравните долю совпадений и сумму по журналу. Порог качества запишите до эксперимента, иначе вы подгоните его под результат. Если дешёвая модель порог проходит, переводите шаг на неё. Промпт, написанный под одну модель, на другой ведёт себя иначе. И не каждая модель принимает оба протокола, так что сверьтесь с карточкой.
Не работает приём там, где ошибка дороже экономии: юридический текст, расчёты, код без ревью. Там сильную модель оставляйте и экономьте в другом месте.
Когда окупается кэш повторяемого префикса?
Кэш удешевляет вход, который повторяется от запроса к запросу: инструкции, схемы инструментов, справочный текст. Три условия: префикс одинаков до символа, он длиннее минимума модели, запросы идут чаще, чем живёт запись. Порог окупаемости считается формулой, её разбор и проверку по usage вы найдёте в статье про prompt caching.
Одно предупреждение из тех, что в списках приёмов пропускают: запись кэша тоже стоит денег. Одиночный запрос с cache_control обходится дороже такого же запроса без разметки. И ещё одна ловушка Relay: кэш не переносится между маршрутами, на резервном маршруте запись оплачивается заново.
Что делать с контекстом, который растёт?
Диалог или агент отправляет в каждом запросе всю историю, и вход растёт с каждым шагом. Три способа его удержать:
Скользящее окно: последние N реплик целиком, всё остальное отбросить.
Сжатие старой части: отдельный вызов делает краткую выжимку, её кладут вместо истории.
Обрезка результатов инструментов: из вывода команды или файла оставляют нужные строки.
Бюджет контекста можно проверять заранее: метод POST /v1/messages/count_tokens возвращает число входных токенов и ничего не списывает. Для больших тел и в некоторых других случаях шлюз присылает собственную оценку с заголовком x-token-count-estimated: true. Стоимость запроса при этом считайте по usage в его ответе, не по подсчёту.
Сжатие истории теряет детали. Если следующему шагу нужна конкретная строка из прошлого вывода, режьте результаты инструментов, а не историю.
Как не платить за повторы и дорогие маршруты?
Повторная отправка это отдельный платный запрос, и стоимость повтора зависит от его собственного исхода. Идемпотентность запросов Relay не поддерживает, поэтому автоповтор без границ превращает сбой в расход. Правила простые: повторять только когда x-should-retry равен true, выдерживать Retry-After, ограничить число попыток и увеличивать паузу. Коды и правила повторов собраны в справочнике ошибок. Отдельная ловушка касается таймаутов: если вы сами закрыли соединение до первого байта, у текстовых запросов списывается оценка входа. Для длинных ответов включайте поток, иначе ошибка upstream_timeout не помечается как повторяемая.
Резервные маршруты работают похожим образом. Если основной маршрут модели недоступен, запрос может уйти на запасной и стоить дороже: оплата идёт по цене маршрута, который ответил. Настройка лежит в ключе: любой доступный маршрут (по умолчанию), только не дороже основного или без запасных. Для одного запроса настройку можно сузить заголовком x-fallback-policy, расширить нельзя. Правила описаны на странице резервных маршрутов.
Мы бы разделили так. Фоновые задачи, которые можно отложить, получают not_pricier или off: сбой для них дешевле дорогого маршрута. Пользовательский чат оставляем на значении по умолчанию, там недоступность ощущается сильнее переплаты.
Есть ли в Relay пакетный режим?
Нет. Среди протоколов Relay пакетного метода нет. У Anthropic Message Batches API принимает пачку запросов асинхронно и берёт за все токены вдвое меньше, пачка до 100 000 запросов или 256 МБ, срок обработки до 24 часов (по документации Anthropic на 14 октября 2026). Через Relay эта скидка недоступна, поэтому для ночных массовых задач план другой: очередь с постоянной параллельностью в пределах лимита запросов ключа, повторы по правилам выше и приёмы 3-6. Цену токена это не снижает, и честнее знать об этом заранее, чем искать скидку, которой нет.
Как понять, что приём сработал?
Сравнивайте не цену запроса, а цену принятого результата. Короткий выход или дешёвая модель легко снижают сумму одного вызова и тут же добавляют повторы и ручные правки, и счёт за задачу растёт. Возьмите фиксированный набор из сотни-двух реальных запросов, прогоните его до и после изменения под одним ключом, сложите charge_usd из CSV и разделите на число ответов, которые вы приняли без доработки. Если число принятых упало, экономия мнимая.
С чего начать за один вечер
Выгрузите CSV, поставьте лимиты на ключи и посмотрите, какая часть цены доминирует: вход или выход. Если выход, начните с третьего приёма, если вход, то с пятого и шестого. Смену модели мы бы оставили на потом: без разбивки её эффект не отличить от случайности.
Снижает ли max_tokens цену запроса?
Само по себе нет: платят за фактически сгенерированные токены. Параметр ограничивает худший случай и размер резерва, который шлюз удерживает на балансе до ответа. Поставьте его по реальной длине ответа с запасом, тогда резерв будет близок к расходу.
Что произойдёт, когда ключ упрётся в лимит?
Запрос получит ошибку key_limit_exceeded, деньги не спишутся. Пополнение баланса лимит ключа не восстанавливает: поднимите лимит в настройках ключа или дождитесь нового дня или месяца, если исчерпан дневной или месячный лимит.
Складываются ли эффекты приёмов?
Не как проценты. Каждый приём действует на свою часть цены, и части пересекаются: после перехода на дешёвую модель кэш экономит меньше в абсолютных числах. Измеряйте итог в журнале после каждого шага, а не перемножайте ожидания.
Источники
Batch processing, документация Anthropic, проверено 14 октября 2026.