RAG на LLM API: как собрать поиск, цитаты и проверку ответа
RAG помогает отвечать по материалам, которых нет в обучении модели или которые регулярно обновляются. Его нельзя свести к одному запросу: система должна подготовить документы, найти кандидатов, отобрать контекст, получить ответ и проверить, что цитаты действительно ведут к переданным фрагментам. Если пропустить любой этап, появится убедительный ответ без опоры на базу знаний.
Коротко
RAG состоит из индексации, retrieval, отбора фрагментов, генерации и проверки источников.
Модель эмбеддингов и векторное хранилище выбирают отдельно: Relay не документирует API эмбеддингов.
Поиск и генерацию оценивают разными наборами метрик, иначе причина ошибки остаётся скрытой.
В ответ попадают идентификаторы только реально найденных документов, а проверка ссылок выполняется в коде.
Какие части нужны минимальному RAG?
У минимального контура пять частей. Сначала документы очищают, делят на осмысленные фрагменты и сохраняют вместе с метаданными. Затем для фрагментов строят представления для поиска. На вопрос пользователя система находит кандидатов, отбирает контекст и передаёт его генеративной модели. После ответа проверяется связь каждой цитаты с тем, что действительно было найдено.
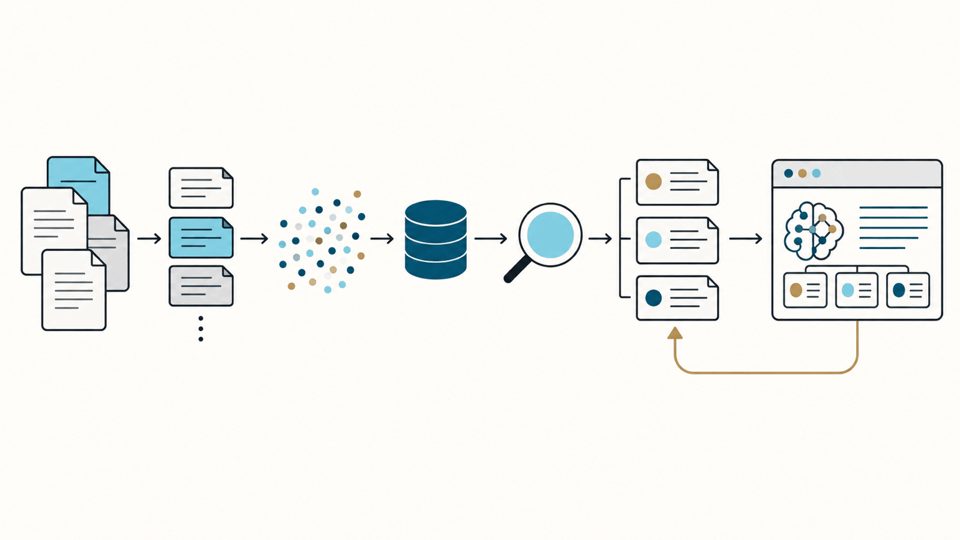
Не начинайте с модели. Первое решение касается корпуса: какие документы допустимы, кто их обновляет, можно ли показывать их разным пользователям и как удалить устаревший фрагмент. Если на эти вопросы нет ответа, поиск будет технически работать, но выдаст данные не тому человеку или из старой версии инструкции.
Как подготовить документы и метаданные?
У каждого фрагмента сохраняйте стабильный идентификатор документа, версию, путь к источнику, права доступа и позицию внутри оригинала. Это нужно для трёх вещей: отфильтровать чужие данные ещё до поиска, показать пользователю проверяемую ссылку и переиндексировать ровно изменившийся документ.
Разделяйте текст по естественным границам: заголовок, раздел, функция, пункт договора. Нельзя выбрать один размер для любого корпуса. Слишком крупный фрагмент тащит в контекст шум. Слишком мелкий теряет условие, исключение и связь с соседним абзацем. Проверьте нарезку на реальных вопросах, а не на одном удачном примере.
В индекс не кладут секреты «на всякий случай». Ограничение выдачи после поиска уже поздно, если фрагмент был доступен неверному ключу или процессу. Применяйте фильтр прав до поиска и повторяйте проверку перед показом цитаты.
Где выполнить эмбеддинг и генерацию?
В документированном списке API Relay нет отдельного метода эмбеддингов. Для построения индекса выберите внешнюю модель эмбеддингов и хранилище, которые подходят языку корпуса, требованиям размещения и обновления. Это отдельный компонент системы, не скрытая возможность чат-модели.
Генерацию итогового ответа можно отправить в Relay. Выберите модель и совместимый протокол в каталоге, передайте отобранные фрагменты в сообщение и получите ответ по Messages API или Chat Completions. Для клиента это обычный запрос с контекстом. Он не получает права на поиск сам по себе.
Для стабильных правил или небольшой общей справки допустим кэшируемый префикс. Возможность зависит от модели, а фактический расход нужно читать по usage. Условия и поля кэша разобраны на странице кэширования запросов.
Как искать, а не угадывать?
Поиск должен вернуть кандидатов шире финального контекста. Затем их можно отфильтровать по правам, свежести и типу документа, после чего переупорядочить. Точный идентификатор, артикул или код ошибки часто плохо переживают поиск только по смыслу. Для таких случаев добавляют буквальный поиск и объединяют результаты с семантическими кандидатами.
Не считайте, что первые результаты автоматически полезны. Просматривайте вопрос, выбранные фрагменты и источник каждого ответа. Если нужный документ даже не попал в кандидаты, корректировка промпта ничего не исправит. Если документ найден, но ответ неверен, проблема может быть в порядке фрагментов, инструкции или самой модели.
Как собрать контекст с цитатами?
Передавайте модели короткий список нумерованных фрагментов вместе с названием источника и разрешённой ссылкой. В инструкции попросите отвечать только по этим фрагментам и признавать отсутствие подтверждения. Ответ должен содержать идентификаторы источников, а не придуманные URL.
источник A, фрагмент 12: текст
источник B, фрагмент 4: текст

вопрос пользователя
После генерации разберите все идентификаторы в ответе. Каждый должен существовать среди переданных фрагментов. Если идентификатор отсутствует, не подставляйте похожую ссылку молча. Либо удалите неподтверждённое утверждение, либо повторите генерацию с указанием ошибки, либо честно сообщите, что источника не найдено.
Такой постпроцессинг особенно важен для ответов в поддержку, справочных карточек и юридически значимых текстов. Он не доказывает, что вывод верен, но не позволяет ссылаться на то, чего модель не видела.
Как оценить поиск и ответ отдельно?
Составьте набор вопросов, где для каждого известен документ или фрагмент, нужный для ответа. Для retrieval измеряйте, попал ли нужный материал в отобранные результаты. Для генерации оценивайте, верен ли вывод при уже правильном контексте, и опирается ли он на цитируемые фрагменты.
Добавьте запросы без ответа в корпусе. Система должна уметь остановиться, а не брать ближайший похожий документ. Отдельно проверьте старые версии документа, одинаковые названия файлов и вопросы с несколькими условиями. Эти случаи чаще ломают RAG, чем простой вопрос с одним очевидным ответом.
При сравнении вариантов считайте и стоимость принятого ответа. Число токенов, расход и статус запроса доступны в журнале запросов, но собственный document_id и метка тестового вопроса остаются на вашей стороне. Связывайте их через свой идентификатор задачи и x-request-id.
Когда нужен reranking?
Переупорядочивание кандидатов пригодится, если быстрый поиск находит много похожих фрагментов, а в контекст помещаются лишь несколько. Оно не должно скрывать плохую индексацию. Сначала убедитесь, что правильный документ вообще находится среди кандидатов, затем решайте, нужен ли дополнительный этап отбора.
Обрабатывайте документы одной версии согласованно. Если часть фрагментов уже переиндексирована, а часть нет, ответ может соединить старое правило с новым исключением. Держите версию индекса в метаданных и переключайте выдачу на новую версию после завершения обновления.
Выбор между RAG, полным контекстом и смешанной схемой разобран в статье длинный контекст или RAG. Она поможет не строить индекс там, где достаточно нескольких стабильных страниц.
Как начать первую итерацию?
Возьмите один узкий корпус и ограниченный набор пользователей. Подготовьте десятки вопросов с известными источниками, включая вопросы без ответа. Сначала реализуйте поиск, возврат фрагментов и проверку цитат. Лишь затем добавляйте переранжирование, сложные фильтры или автономные действия агента.
Индекс должен быть наблюдаемым. Для каждого ответа сохраняйте версию индекса, идентификаторы кандидатов, финальные фрагменты, решение проверки цитат и идентификатор запроса модели. Без этого невозможно отличить регрессию поиска от регрессии генерации.
Как работать с изменениями и удалениями?
Индекс живёт дольше одного запроса, поэтому ему нужен явный процесс обновления. При изменении исходного документа найдите его старые фрагменты, подготовьте новые и переключите выдачу только после успешной проверки версии. Иначе один ответ соберётся из несовместимых редакций инструкции.
Удаление требует не меньшего внимания. Удалённый документ должен исчезнуть из поиска, кэшей и выдачи цитат. Если у вас есть резервные копии индекса, для них тоже определите срок хранения и правила доступа. Это часть работы с данными, а не косметика для поискового качества.
Метаданные помогают сделать обновление точным. Хеш источника показывает, что текст изменился. Версия документа связывает фрагменты между собой. Время индексации позволяет заметить задержку. Но не подменяйте этими полями сам текст: контрольная проверка должна читать и фактические результаты поиска.
Как обрабатывать вопрос вне корпуса?
Добавьте отдельное состояние «источник не найден». Оно лучше правдоподобного ответа по близкой теме. Для такого состояния задайте правило интерфейса: попросить уточнение, показать доступные разделы или передать вопрос человеку. Не подсовывайте модели случайный фрагмент лишь для того, чтобы она ответила.
Эта ветка должна попасть в тестовый набор. Если доля честных отказов резко выросла после обновления индекса, возможно, поисковый фильтр стал слишком строгим. Если она внезапно исчезла, возможно, система стала отвечать по нерелевантным текстам. Оба сигнала требуют чтения выборки, а не одной сводной цифры.
Можно ли построить RAG только на чат-модели?
Для генерации ответа чат-модель подходит, но для индекса нужна отдельная стратегия представления и поиска документов. В документированном API Relay нет отдельного метода эмбеддингов, поэтому модель для индекса и хранилище выбирают отдельно. Затем найденный контекст передают модели через обычный запрос.
Нужно ли всегда добавлять reranking?
Нет. Сначала измерьте, хватает ли основного поиска на вашем наборе вопросов. Если нужный документ уже стабильно попадает в короткий список, дополнительный этап может только усложнить систему. Reranking имеет смысл, когда кандидатов много и порядок заметно влияет на качество ответа.
Как обновлять документы без старых ответов?
Привязывайте фрагменты к версии источника. При обновлении пересобирайте все затронутые фрагменты и переключайте поиск на согласованную версию индекса. В журнале ответа сохраняйте версию, чтобы позже воспроизвести, по каким материалам был дан конкретный ответ.