Длинный контекст или RAG: как выбрать подход для данных
RAG или длинный контекст выбирают не по размеру окна модели, а по устройству данных и вопроса. Небольшой стабильный набор документов проще передать целиком. Большой или быстро меняющийся корпус требует поиска. Между этими полюсами часто работает гибрид: постоянная часть остаётся во входе, а свежие фрагменты находятся перед каждым запросом.
Коротко
Стабильный корпус, по которому задают вопросы разного типа, часто проще передать целиком.
Если пользователь обычно спрашивает о нескольких фрагментах из большого корпуса, нужен retrieval.
Кэш полезен для неизменяемого префикса, но не заменяет поиск по обновляемым данным.
Решение проверяют на собственном наборе вопросов: отдельно точность, расход и отказ от ответа.
С какого вопроса начать выбор?
Спросите не «сколько токенов вмещает модель», а «какой материал реально нужен для одного ответа». Если помощник анализирует один договор, всю спецификацию или историю одного обращения, целостный контекст сохраняет связи между разделами. Если он ищет номер детали среди тысяч документов, в промпт лучше положить найденные фрагменты и их источник.
Есть короткая эвристика. Представьте, что вопрос отвечает опытный сотрудник. Он бы прочёл весь небольшой документ или открыл несколько мест по поиску? Первый вариант ближе к длинному контексту, второй к RAG. Это начало решения, а не готовый вердикт.
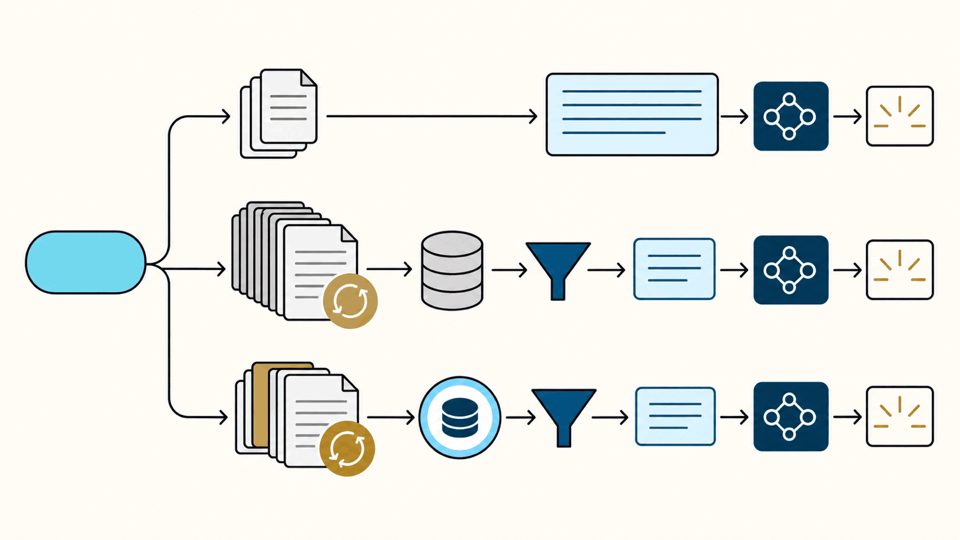
По каким признакам сравнивать подходы?
Размер корпуса важен, но не один. Смотрите на обновляемость, повторяемость запросов, цену пропущенного факта и тип вопроса. В таблице нет жёстких порогов: они зависят от модели, текста и требований приложения.
| Признак задачи | Длинный контекст | RAG | Гибрид |
|---|---|---|---|
| Корпус небольшой и почти не меняется | Часто подходит | Добавляет лишнюю систему | Нужен редко |
| Вопрос требует связать части одного документа | Сохраняет общий ход мысли | Может выдать неполную выборку | Подходит при дополнительном поиске |
| Корпус растёт и обновляется каждый день | Контекст быстро устаревает | Индекс можно обновлять частями | Постоянные правила остаются во входе |
| Важен точный источник ответа | Нужна разметка источников | Поиск и ссылки на фрагменты удобнее | Работает для постоянных и свежих данных |
Длинный контекст проще сопровождать. Не нужны эмбеддинги, индекс и отдельный ранжировщик. Его слабое место другое: каждый запрос несёт весь выбранный материал, даже когда вопрос касается одной строки. Большой массив отвлекает модель, а вам приходится следить за ростом входа.
RAG держит рабочий контекст короче, но создаёт новую поверхность отказов. Неподходящая нарезка, устаревший индекс или слабый поиск могут скрыть нужный документ ещё до того, как модель увидит вопрос. Ответ будет гладким и при этом не опираться на источник.
Как посчитать расход без выдуманных цен?
Для длинного контекста оцените вход на одну задачу как размер материала, умноженный на число ходов. Для RAG сложите входные токены выбранных фрагментов каждого хода. Поиск и обработка его результатов измеряются отдельно: это работа системы, а не входные токены модели. Точные ставки не переносите в код и текст: в Relay они показываются в карточке модели и зависят от выбранной модели.
вход длинного контекста ≈ число ходов × токены всего корпуса
вход RAG ≈ сумма токенов выбранных фрагментов по ходам
Формула не заменяет журнал. У агента один вопрос может вызвать несколько ходов, а история сообщения растёт после каждого результата инструмента. Откройте журнал запросов, сравните вход, выход, компоненты кэша и число запросов у двух вариантов на одном наборе задач. Время и цена поиска остаются отдельной строкой сравнения. Затем считайте стоимость принятого ответа, а не отдельного вызова.
Где помогает кэш?
Кэш полезен, когда один и тот же префикс повторяется без изменений: правила ответа, терминология, стабильная документация. В Messages API поля cache_control проходят к модели, но возможность и точная тарификация зависят от выбранной модели. Про условия, разбивку usage и отличия протоколов написано в справочнике кэширования.
Кэш не исправляет плохой поиск. Он также не делает обновляемый корпус постоянным: малейшее изменение рабочего префикса может уменьшить повторное использование. Поэтому для базы знаний, которая меняется, разделите слои. Постоянные инструкции и правила держите отдельно, а найденные фрагменты добавляйте ближе к вопросу.
Стратегии и расчёт окупаемости кэша разобраны в статье про prompt caching в LLM API. Там же видно, почему результат надо считать по реальным полям usage, а не по приблизительному числу символов.
Что такое хороший RAG в этом сравнении?
RAG не равен «взять несколько случайных абзацев». Нужны подготовка документов, поиск кандидатов, отбор наиболее полезных фрагментов и проверка того, что ответ ссылается только на переданный материал. Модель эмбеддингов и хранилище векторов подбирают отдельно: в перечне документированных API Relay нет метода эмбеддингов. Генерацию ответа при этом можно выполнять через Relay по подходящему протоколу.
Важна граница между поиском и ответом. Поиск отвечает за то, чтобы принести нужный фрагмент. Модель отвечает за объяснение и синтез. Если смешать эти этапы в одну метрику, вы не поймёте, куда направлять правку. Оценивайте поиск и ответ раздельно, иначе нельзя понять источник ошибки.
Как провести короткий эксперимент?
Соберите вопросы, которые действительно задают пользователи. Для каждого сохраните ожидаемый документ или факт и отметьте, допустим ли честный отказ. Затем реализуйте три варианта: полный контекст, RAG и гибрид. Не меняйте между ними системные правила, модель и критерии оценки.
Проверьте четыре колонки: найден ли нужный источник, верен ли ответ, сколько входных токенов ушло на задачу и сколько раз система сказала «не знаю». Добавьте вопросы с фактами в начале, середине и конце длинного материала. Так проявится ситуация, когда контекст формально помещается, но важная деталь тонет среди соседнего текста.
Историю диалога не смешивайте с базой знаний. Для истории есть свои правила сокращения и хранения контекста, они разобраны в статье как устроены токены истории чата. Иначе эксперимент измерит рост переписки, а не качество знания.
Какой выбор сделать первым?
Начните с самого простого варианта, который можно измерить. Маленький неизменяемый корпус попробуйте передать целиком. Если появились пропуски, рост входа или сложность обновлений, добавляйте поиск. Не стройте векторный контур ради модного слова, но и не кладите весь архив в каждый запрос только потому, что окно это выдерживает.
Какие ошибки маскирует большой контекст?
Большое окно создаёт приятную иллюзию, что поиск больше не нужен. Но модель может увидеть все документы и всё равно выбрать не тот раздел, пропустить исключение или соединить две похожие версии правила. Чем больше нерелевантного текста рядом, тем важнее порядок подачи и формулировка вопроса.
Проверяйте случаи с почти одинаковыми документами. Один может относиться к архивной версии, другой к текущей. Если полный контекст содержит оба, инструкция должна объяснять приоритет и дату. Если RAG выбрал один, система должна сохранить, почему именно этот фрагмент попал в ответ. Без такой записи спор об ошибке сводится к догадкам.
Не обещайте, что длинный контекст исправит нехватку данных. Он передаёт модели только то, что вы положили в запрос. Внешний факт, свежая запись или закрытая часть базы не появятся от увеличения окна. Для них нужны источник, политика доступа и отдельная операция получения данных.
Как обновлять выбранную стратегию?
Вернитесь к набору вопросов после крупного изменения корпуса, инструкции или модели. Для полного контекста посмотрите, не стал ли он слишком длинным и не ухудшилось ли место нужных сведений. Для RAG проверьте, что свежие документы индексируются и старые версии больше не выдаются.
Решение не обязано быть вечным. Небольшой справочник порой вырастает в архив, а RAG для активной базы теряет смысл после выделения нескольких устойчивых разделов. Сохраняйте причину первоначального выбора и метрики эксперимента, тогда смена подхода станет инженерным решением, а не спором о вкусе.
Заменяет ли длинный контекст поиск по базе знаний?
Нет. Он удобен, когда материал целостный и нужен почти целиком. Поиск нужен, когда источник велик, меняется или вопрос относится к небольшой части корпуса. Даже при большом окне правильный фрагмент может остаться среди нерелевантного текста и не повлиять на ответ.
Нужен ли RAG для нескольких страниц документации?
Чаще нет. Сначала попробуйте передать страницы целиком и оцените ответы на реальных вопросах. RAG добавляет индекс, переиндексацию и диагностику поиска. Он оправдан, когда материал растёт, часто меняется или вы уже видите, что модель тратит контекст на ненужные разделы.
Как не выдавать выдуманные цитаты?
Передавайте модели идентификаторы и ссылки только тех фрагментов, которые реально попали в контекст. После ответа программно проверяйте каждую ссылку по этому списку. Если подтверждения нет, покажите отказ или попросите уточнить вопрос. Не позволяйте модели придумывать адреса источников.