Задержка LLM API: как измерить TTFT и сократить ожидание
Ответ LLM приходит с задержкой из трёх частей: время до первого токена (TTFT), скорость генерации и сеть. Прежде чем что-то ускорять, измерьте их на своём ключе и своём промпте. Цифры из чужих обзоров снимали в другой сети, при другой нагрузке и на другой длине запроса. Ниже скрипт для замера и приёмы по порядку, от дешёвых к дорогим.
Коротко
TTFT показывает, как долго вы ждёте первый фрагмент текста после отправки запроса. Скорость генерации считайте по токенам вывода за время после этого фрагмента.
Ускоряют ответ короткий вывод, стриминг, кэш длинного неизменного начала запроса, подходящая модель и параллельные независимые вызовы.
Чисел задержек в статье нет, потому что их определяют модель, длина запроса и ваша сеть. Скрипт покажет ваши.
Из чего складывается задержка ответа?
Запрос проходит пять участков. Сначала он ждёт в очереди вашего приложения и проходит ваш код, потом идёт по сети к шлюзу, где добавляются накладные расходы. Дальше модель читает вход, выдаёт первый токен и генерирует остальное.
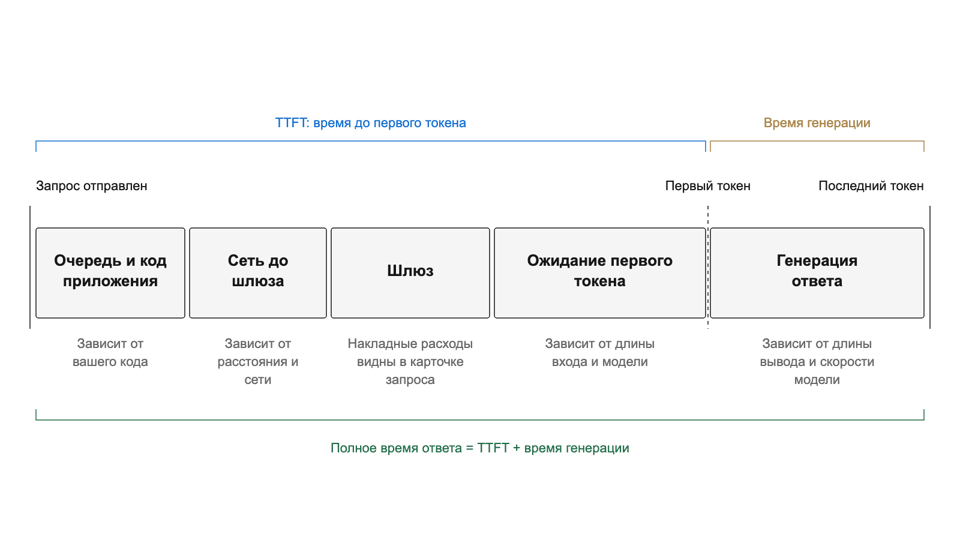
Из схемы видно, что полное время равно TTFT плюс время генерации, а генерация длится тем дольше, чем больше токенов вывода. Поэтому длинный ответ при быстром TTFT всё равно придёт нескоро, а короткий ответ на длинный вход упрётся в ожидание первого токена. Без стриминга вы получаете ответ только в конце, и для пользователя TTFT совпадает с полным временем. Со стримингом текст начинает появляться раньше, хотя общее время остаётся прежним.
Как измерить TTFT и скорость на своём ключе?
Скрипт делает десять потоковых запросов подряд и печатает медиану и p90 для TTFT, полного времени и скорости генерации. TTFT он отсчитывает до первого фрагмента с видимым текстом. Скорость он считает как токены вывода из usage, делённые на время после первого фрагмента. Разбор потока здесь тот же, что в статье про SSE на TypeScript и Python: событие считается полученным только после пустой строки. Замер засчитывается, если поток дошёл до [DONE]; события error и оборванные потоки скрипт считает неудачными и показывает их число отдельно. Первый запрос только устанавливает соединение, его результат скрипт отбрасывает, а сбой этого запроса останавливает скрипт с сообщением:
import json
import os
import statistics
import sys
import time

import httpx

URL = "https://relay-llm.ru/v1/chat/completions"
HEADERS = {"Authorization": f"Bearer {os.environ['RELAY_API_KEY']}"}
PROMPT = "Объясни одним абзацем, чем TCP отличается от UDP."
FAILURES = (httpx.HTTPError, RuntimeError, ValueError)


def sse_events(lines):
    event, data = "message", []
    for line in lines:
        if line == "":
            if data:
                yield event, "\n".join(data)
            event, data = "message", []
        elif not line.startswith(":"):
            field, _, value = line.partition(":")
            value = value.removeprefix(" ")
            if field == "event":
                event = value
            elif field == "data":
                data.append(value)


def measure(client, model):
    body = {
        "model": model,
        "stream": True,
        "stream_options": {"include_usage": True},
        "max_tokens": 300,
        "messages": [{"role": "user", "content": PROMPT}],
    }
    started = time.perf_counter()
    first = None
    tokens = None
    done = False
    with client.stream("POST", URL, headers=HEADERS, json=body) as response:
        response.raise_for_status()
        for event, data in sse_events(response.iter_lines()):
            if event == "error":
                raise RuntimeError(data)
            if data == "[DONE]":
                done = True
                break
            chunk = json.loads(data)
            choices = chunk.get("choices") or []
            if first is None and choices and choices[0]["delta"].get("content"):
                first = time.perf_counter()
            if chunk.get("usage"):
                tokens = chunk["usage"]["completion_tokens"]
    finished = time.perf_counter()
    if not done or first is None or not tokens or finished <= first:
        raise RuntimeError("неполный замер")
    return first - started, finished - started, tokens / (finished - first)


def p90(values):
    ordered = sorted(values)
    return ordered[round(0.9 * (len(ordered) - 1))]


def main(model, runs=10):
    ttft, total, speed = [], [], []
    failed = 0
    with httpx.Client(timeout=httpx.Timeout(10.0, read=120.0)) as client:
        try:
            measure(client, model)
        except FAILURES as exc:
            sys.exit(f"{model}: прогревочный запрос не удался: {exc}")
        for _ in range(runs):
            try:
                result = measure(client, model)
            except FAILURES:
                failed += 1
                continue
            ttft.append(result[0])
            total.append(result[1])
            speed.append(result[2])
    if not ttft:
        sys.exit(f"{model}: ни один замер не удался")
    print(f"{model}: успешных замеров {len(ttft)} из {runs}, неудачных {failed}")
    for name, values in (("TTFT, с", ttft), ("всего, с", total), ("токенов/с", speed)):
        print(f"{model}  {name}: p50 {statistics.median(values):.2f}  p90 {p90(values):.2f}")


if __name__ == "__main__":
    main(sys.argv[1] if len(sys.argv) > 1 else "claude-sonnet-5")
Запускайте скрипт оттуда, где работает приложение: с ноутбука вы измерите сеть до ноутбука, а не до сервера. Запросы тарифицируются как обычные, пусть и короткие, поэтому цену смотрите в карточке модели. Десяти запросов хватает только для грубой картины: p90 на такой выборке условен. Для надёжного хвоста нужны несколько десятков запросов, и замер дорожает вместе с ними.
Сверьте результат с карточкой запроса в журнале. У каждого запроса там три значения: первый байт, время ответа и накладные расходы шлюза. Разница между вашим замером и этими числами показывает, сколько времени уходит на сеть до шлюза и на ваш код. Рядом видны повторы и маршрут, основной или резервный. Если у части запросов есть повторы или резервный маршрут, ими может объясняться хвост распределения, а не моделью.
Что сокращает ожидание сильнее всего?
Приёмы ниже стоят в том порядке, в каком я бы их пробовал. Каждый проверяйте тем же скриптом: польза зависит от вашего запроса.
Сократите вывод. Генерация длится тем дольше, чем больше токенов, поэтому прямой способ ускориться: просить меньше. Задайте реальный потолок в
max_tokens, назовите длину ответа в инструкции и добавьте стоп-последовательность, если конец предсказуем (stopв Chat Completions,stop_sequencesв Messages). Relay передаёт эти поля модели без изменений, а поддержку конкретного параметра определяет модель.Включите стриминг. Полное время он не сокращает, зато текст начинает появляться на TTFT, и ожидание ощущается короче. Интерфейсам это нужно, фоновой обработке нет. Код разбора и формат событий разобраны в статье про SSE, на которую ведёт ссылка выше.
Кэшируйте длинное неизменное начало. Anthropic пишет, что кэш промпта обычно улучшает TTFT на длинных документах (страница кэширования на 14 октября 2026 года). Помеченный блок по умолчанию живёт 5 минут и продлевается при каждом обращении. Relay передаёт метку
cache_controlмодели как есть, а чтение и запись кэша тарифицирует по отдельным ставкам, их описывает страница кэша. Эффект проверьте по полямusageи по TTFT на втором запросе подряд.Подберите модель. Для коротких шагов вроде классификации самая сильная модель нужна не всегда. Прогоните скрипт на двух кандидатах из каталога с одним промптом и сравните скорость и качество на своих данных.
Распараллельте независимые вызовы. Если шагу нужны три несвязанных ответа, не ждите их по очереди: общее время станет равно самому долгому, а не сумме.
Параллелизм упирается в лимиты. У обычных текстовых запросов ограничен только темп запросов в минуту, у потоков есть ещё потолок одновременных потоков. Обе границы разобраны в статье про rate limits. Когда параллельных задач много, поставьте очередь, как в материале про параллельные запросы:
import asyncio
import os

import httpx

URL = "https://relay-llm.ru/v1/chat/completions"
HEADERS = {"Authorization": f"Bearer {os.environ['RELAY_API_KEY']}"}


async def fan_out(prompts):
    async with httpx.AsyncClient(timeout=httpx.Timeout(10.0, read=120.0)) as client:

        async def call(prompt):
            response = await client.post(
                URL,
                headers=HEADERS,
                json={
                    "model": "gpt-5.6-luna",
                    "max_tokens": 200,
                    "messages": [{"role": "user", "content": prompt}],
                },
            )
            response.raise_for_status()
            return response.json()["choices"][0]["message"]["content"]

        return await asyncio.gather(*(call(p) for p in prompts))


if __name__ == "__main__":
    for answer in asyncio.run(fan_out(["Назови столицу Франции.", "Назови столицу Японии.", "Назови столицу Канады."])):
        print(answer)
Что проверить, если TTFT вырос?
Идите по порядку, от своего кода к модели. Сначала очередь приложения: сравните время ожидания в вашем пейсере или пуле соединений с длительностью активных запросов. Очередь может расти и потому, что ответы стали дольше, поэтому по одной очереди API не исключить. Затем длина входа: растущая история диалога удлиняет работу модели до первого токена, поэтому сравните usage.prompt_tokens сегодняшних запросов с прошлонедельными. Потом карточка запроса: повторы и резервный маршрут добавляют ожидание и видны в журнале. Дальше сеть: сравните свой TTFT с первым байтом из карточки. Модель и её нагрузку подозревайте последними. Если остальное не объясняет рост, меняйте модель или пишите в поддержку с request_id медленного запроса.
Почему одной медианы мало?
Таймауты клиента срабатывают на самых медленных запросах, а не на типичных. Таймаут, равный медиане, оборвёт половину запросов, а таймаут на уровне p90 оборвёт каждый десятый. Поэтому смотрите на p90 и выше, а таймаут ставьте с запасом над ним.
У таймаута есть цена. Если шлюз уже отправил запрос модели, а вы закрыли соединение до первого байта ответа, у текстовых запросов спишется оценка входа, хотя ответа вы не получили. Слишком короткий таймаут на длинных запросах превращает деньги в ничто. Правила списания при ошибках описаны в справочнике ошибок.
С чего начать, если времени мало?
Я бы начал с замера: без него неясно, какой участок тормозит. Потом сократил бы вывод: это дёшево. Затем включил бы стриминг везде, где ответ читает человек, и кэш для длинного повторяющегося начала. Модель менял бы последней, потому что смена задевает качество ответов. Параллелизм подключал бы там, где есть независимые шаги, и только вместе с очередью.
Что такое TTFT?
Time to first token, время от отправки запроса до первого токена ответа. В потоковом запросе вы измеряете его напрямую: это момент, когда пришёл первый фрагмент с текстом. Без потока клиент получает ответ целиком, и TTFT совпадает с полным временем.
Чем задержка отличается от скорости генерации?
Задержка до первого токена складывается из очереди, сети и обработки входа. Скорость генерации показывает, сколько токенов вывода модель выдаёт в секунду после этого. Для длинных ответов решает вторая величина, для коротких ответов на длинный вход первая.
Можно ли верить замерам из обзоров?
Как ориентир для выбора кандидатов можно, как цифры для своего продукта нельзя. Сеть, длина промпта, нагрузка и модель у вас другие. Скрипт выше даёт числа для вашей конфигурации на вашу дату.
Что показывает карточка запроса в журнале?
Три значения времени: первый байт, ответ и накладные расходы шлюза. Рядом указаны маршрут, основной или резервный, и число повторов. Сетевую задержку между вашим сервером и шлюзом карточка не измеряет, её даёт замер на вашей стороне.
Источники
Prompt caching, документация Anthropic, проверено 14 октября 2026 года.