Как сравнить LLM-модели на своих данных: набор из 20 примеров
Чтобы сравнить модели на своих данных, соберите двадцать реальных запросов из продукта, для каждого запишите проверяемый критерий и прогоните набор через два-три ID одним и тем же промптом. Сравнивайте две цифры: долю прошедших ответов и цену одного прошедшего. Ниже набор, скрипт и правила чтения результата.
Коротко
Двадцать настоящих примеров с критерием «верно или нет» говорят о вашей задаче больше, чем чужой рейтинг.
Скрипт из статьи прогоняет набор через несколько моделей и печатает долю прошедших и цену прошедшего ответа.
Порог задайте до запуска. Побеждает самая дешёвая модель, которая его проходит.
Результат стареет вместе с моделью, поэтому набор хранится рядом с кодом.
Почему общий рейтинг не решает вашу задачу?
Рейтинг усредняет множество разных задач, а ваша в нём одна строка, сформулированная не так, как у вас. В нём нет вашего формата документов, ваших категорий и ваших требований к тону. В нём нет и цены, которую вы заплатите за прошедший ответ: она зависит от длины ваших промптов и от каталога на день запуска.
Для списка кандидатов рейтинг сгодится. Для решения нет. Кандидатов проще взять прямо в каталоге: две-три модели соседних ценовых уровней.
Из чего собрать набор?
Нужны примеры, критерий к каждому и разумный состав.
Примеры берите из своей системы: тикеты, письма, строки логов, закрытые баги. Тексты запросов Relay не хранит, так что выгрузить их из журнала не получится. Придуманные формулировки чище настоящих и завышают результат, поэтому пишите свои только там, где реальных не хватает.
Состав: в основном типичные запросы и несколько граничных, то есть пустой ввод, очень длинный, двусмысленный. Граничные нужны затем, чтобы увидеть, где модели расходятся: на типичных запросах результаты могут совпасть.
Критерий проверяется кодом, и у него три формы. Поле equals требует точного совпадения ответа и годится для закрытых ответов: метка, число, да или нет. Для свободного текста есть must с подстроками, которые должны быть в ответе, и must_not с теми, которых быть не должно. Подстрока слабее точного совпадения: ответ «это не bug» пройдёт проверку must: ["bug"]. Поэтому для свободного текста формулируйте критерий узко, например «содержит номер заказа из обращения» и «не обещает возврат денег», а часть прошедших ответов всё равно прочитайте глазами.
{"id": "t01", "prompt": "Клиент пишет: после обновления кнопка «Сохранить» не нажимается. Определи категорию: bug, question или feature. Ответь одним словом.", "equals": "bug"}
{"id": "t02", "prompt": "Клиент спрашивает по заказу 4815, пришла ли посылка повреждённой. Напиши ответ в два предложения.", "must": ["4815"], "must_not": ["вернём деньги"]}
Один пример на двадцати весит пять процентов. Разницу в один-два примера считайте шумом: измерить её набор такого размера не может. Если модели разошлись на мелочь, добавьте ещё тридцать примеров и сравните снова.
Как прогнать набор через несколько моделей?
Схема простая: примеры и критерий идут в прогон, прогон по моделям складывается в таблицу.
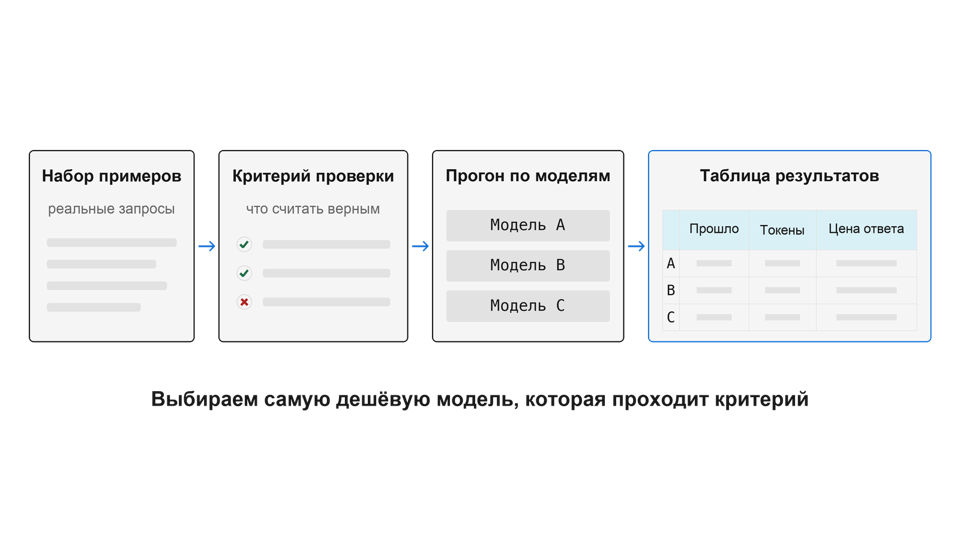
Скрипт ниже отправляет каждый пример в POST /v1/chat/completions, проверяет ответ по equals, must и must_not, суммирует токены из usage и оценивает стоимость по ценам из GET /v1/models/{id}.
import json
import os
import sys
from decimal import Decimal
from urllib.error import HTTPError
from urllib.request import Request, urlopen

BASE = os.environ.get("RELAY_BASE_URL", "https://relay-llm.ru/v1")
HEADERS = {"Authorization": "Bearer " + os.environ["RELAY_API_KEY"], "Content-Type": "application/json"}


def call(path, body=None):
    data = json.dumps(body).encode() if body else None
    with urlopen(Request(BASE + path, data, HEADERS), timeout=180) as resp:
        return json.load(resp)


def describe(model, err):
    return "%s: HTTP %d, x-request-id %s" % (model, err.code, err.headers.get("x-request-id"))


def passed(answer, case):
    text = answer.strip().lower()
    if "equals" in case:
        return text == case["equals"].lower()
    has_all = all(s.lower() in text for s in case.get("must", []))
    has_none = not any(s.lower() in text for s in case.get("must_not", []))
    return has_all and has_none


def run_model(model, cases):
    try:
        price = call("/models/" + model)["pricing"]
    except HTTPError as err:
        sys.exit(describe(model, err))
    ok = tokens_in = tokens_out = 0
    rows = []
    for case in cases:
        try:
            reply = call("/chat/completions", {"model": model, "messages": [{"role": "user", "content": case["prompt"]}]})
        except HTTPError as err:
            print(describe(model + " " + case["id"], err))
            rows.append({"id": case["id"], "pass": False, "answer": ""})
            continue
        answer = reply["choices"][0]["message"]["content"] or ""
        verdict = passed(answer, case)
        ok += verdict
        tokens_in += reply["usage"]["prompt_tokens"]
        tokens_out += reply["usage"]["completion_tokens"]
        rows.append({"id": case["id"], "pass": verdict, "answer": answer})
    with open("result-%s.jsonl" % model, "w", encoding="utf-8") as out:
        out.writelines(json.dumps(r, ensure_ascii=False) + "\n" for r in rows)
    cost = tokens_in * Decimal(price["prompt"]) + tokens_out * Decimal(price["completion"])
    per_pass = "нет прошедших" if not ok else "%.6f $" % (cost / ok)
    print("%s: прошло %d из %d, цена запроса %.6f $, цена прошедшего ответа %s" % (model, ok, len(cases), cost / len(cases), per_pass))


def main(cases_path, models):
    with open(cases_path, encoding="utf-8") as f:
        cases = [json.loads(line) for line in f if line.strip()]
    for model in models:
        run_model(model, cases)


if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2:])
Запуск: сохраните скрипт как eval_models.py, положите набор в cases.jsonl, подставьте свой ключ и перечислите модели.
export RELAY_API_KEY="замените-на-свой-ключ"
python3 eval_models.py cases.jsonl gpt-5.6-luna claude-sonnet-5
На выходе по строке на модель: сколько примеров прошло, сколько стоил запрос и сколько стоил один прошедший ответ. Ответы каждой модели лежат в result-<модель>.jsonl. Их придётся прочитать самим, и об этом ниже.
Три оговорки. Цены в GET /v1/models/{id} даны без персональной скидки, поэтому итог остаётся оценкой, а настоящую стоимость каждого вызова покажет журнал запросов. Если ID нет в каталоге, прогон остановится с кодом HTTP и x-request-id, который пригодится в обращении в поддержку. Параметры вроде temperature в запрос не добавлены намеренно: часть моделей отвергает нестандартные значения, по странице Anthropic на 14 октября 2026 года это Claude 4.7 и новее.
Промпт для всех моделей один и тот же. Если писать каждой свой, вы сравните не модели, а умение писать промпты. Скрипт ходит через Chat Completions, значит подходят модели, у которых в protocols указан openai_chat, а подробности запроса описаны в документации. Картинки и видео идут другими путями, и этот скрипт для них не годится.
Как читать результат?
Порог проходимости выберите до запуска, например восемнадцать из двадцати. Иначе после прогона начнёт казаться, что подходит любой результат. Побеждает самая дешёвая модель из прошедших порог, а не самая сильная.
Упавшие ответы читайте глазами. Часть падений вина критерия: ответ верный, но написан иначе, чем вы ожидали. Критерий поправьте и перепрогоните набор целиком. Часть падений настоящая, и в них видно, где модель ошибается: путает категории, пропускает поле, добавляет лишнее. Из прошедших ответов тоже прочитайте несколько: подстрочный критерий засчитывает и случайное совпадение.
Пограничный результат прогоните ещё раз. Ответы модели от запуска к запуску могут отличаться, и разница в один пример при повторе нередко исчезает. Если не проходит ни одна модель, проверяйте по порядку критерий, промпт и только потом кандидатов.
Свою позицию мы бы сформулировали так: двигаться снизу вверх. Начните с самой дешёвой модели из списка, смотрите, где она падает, и поднимайтесь на ступень выше, только если эти падения нельзя починить промптом. Для выбора внутри задач с кодом полезно читать и статью про выбор модели для кода.
Когда набор пора пересобрать?
Когда вышла новая версия модели, которую вы используете, изменился формат входных данных или в продукте появился новый класс запросов. Старая оценка на новой версии может ошибаться в обе стороны.
Храните набор, скрипт и файлы result-*.jsonl рядом с кодом, с датой прогона и списком ID. Через полгода по ним будет видно, почему выбрана именно эта модель, и не придётся пересчитывать всё заново.
Частые вопросы
Сколько примеров достаточно?
Двадцать подходит для первого сравнения: этого хватает, чтобы увидеть грубые провалы. Когда модели идут вровень, добавьте тридцать-пятьдесят примеров. Один пример на двадцати весит пять процентов, на пятидесяти два, так что разницу в один-два примера на малом наборе считайте шумом, а не победой.
Можно ли проверять ответы другой моделью?
Можно, когда подстроки не подходят, например для свободных текстов. Но судья тоже модель. Проверьте его вердикты вручную на части примеров, прежде чем доверять, и не используйте одну и ту же модель как кандидата и как судью.
Как прикинуть месячный расход по результатам прогона?
Для бюджета берите цену запроса, а не цену прошедшего ответа: платить приходится и за непрошедшие. Умножьте цену запроса из прогона на месячный объём. Это оценка: скрипт берёт цены без персональной скидки и не учитывает кэш и повторы. После первой недели сверьте её с расходом в журнале запросов кабинета. Цену прошедшего ответа используйте для сравнения моделей между собой.
Где взять список моделей для сравнения?
В каталоге и в ответе Models API. Берите ID без изменений и сверяйте протоколы: скрипт использует Chat Completions, поэтому у модели в поле protocols должен стоять openai_chat. Кандидатов выбирайте из соседних ценовых уровней, а не по месту в чужом рейтинге.
Источники
Anthropic, страница о выводе моделей из работы, проверена 14 октября 2026 года: отказ от нестандартных
temperature,top_p,top_kна Claude 4.7 и новее.